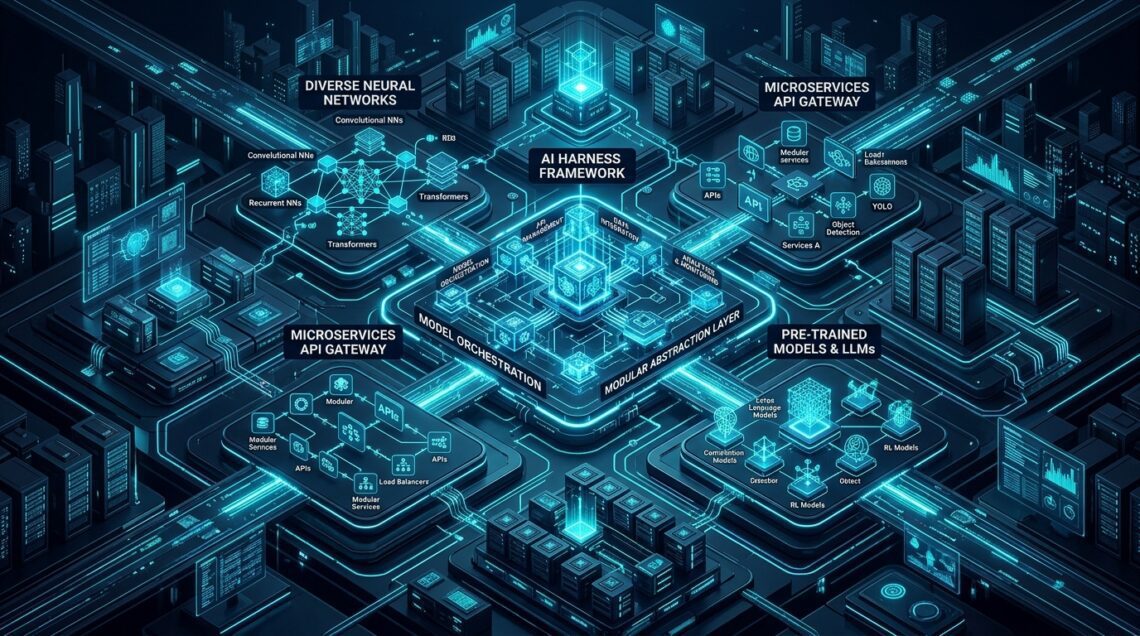
در عصر انفجار مدل های هوش مصنوعی مولد، بهره گیری مستقیم و خام از API های اختصاصی به بزرگ ترین چالش تیم های فنی تبدیل شده است. پیاده سازی معماری AI Harness به عنوان یک لایه انتزاعی (Abstraction Layer) و چارچوب مدیریتی پیشرفته، راهکاری بنیادین است که به سازمان ها امکان می دهد گردش کارهای هوش مصنوعی (AI Workflows) خود را یکپارچه، مقیاس پذیر، پایدار و قابل نظارت سازند. در این مقاله تحلیلی از وبلاگ طراحان نوین، با نگاهی مهندسی و معمارانه، به بررسی چرایی نیاز به این لایه حیاتی، اجزای ساختاری آن و استراتژی های کاهش هزینه و تاخیر می پردازیم.
۱. مقدمه: چرا در دنیای مدل های پراکنده به AI Harness نیاز داریم؟
در مراحل نخست پیدایش تب هوش مصنوعی مولد، غالب توسعه دهندگان با فراخوانی مستقیم توابع کتابخانه هایی نظیر OpenAI SDK، برنامه های خود را شکل دادند. این رویکرد برای نمونه های اولیه (PoC) بسیار سریع و موثر به نظر می رسید. اما با ورود سیستم ها به مقیاس سازمانی و تولید (Production)، اتصال مستقیم کدهای تجاری به یک مدل خاص به یک گلوگاه بحرانی تبدیل شد.
هر چند هفته یک بار شاهد عرضه مدل های برتر جدیدی مانند مدل های استدلالی اوپن ای آی یا شاهکارهای گوگل هستیم که بررسی ابعاد آن در تحلیل هوش مصنوعی Gemini 4 Argon گوگل نشان دهنده سرعت سرسام آور این دگرگونی ها است. بدون وجود یک لایه انتزاعی مستحکم، هر ارتقای نگارش یا تغییر مدل مستلزم بازنویسی عمیق کدهای پایگاه داده، منطق پرامپت ها و تست های سیستم خواهد بود.
مفهوم «Harness» در مهندسی سنتی نرم افزار به بستری اطلاق می شود که کد هدف را در بر می گیرد تا امکان اجرای امن، شبیه سازی شرایط محیطی، اعتبارسنجی خروجی ها و اندازه گیری کارایی را فراهم کند. در قلمرو هوش مصنوعی مدرن، معماری AI Harness دقیقاً همین نقش حیاتی را ایفا می کند؛ چارچوبی که تمام تعاملات میان لایه کاربرد و موتورهای پردازشی را کنترل و بهینه سازی می نماید.
۲. چالش های فعلی توسعه هوش مصنوعی در مقیاس سازمانی
تیم های مهندسی در مسیر استقرار سامانه های مبتنی بر هوش مصنوعی مولد با مجموعه ای از موانع ساختاری روبرو هستند که معماری سیستم را تهدید می کنند:
- پدیده مدل زدگی و قفل شدن به فروشنده (Model Fatigue & Vendor Lock-in): وابستگی شدید کدهای تجاری به قالب های پیام، پارامترهای منحصر به فرد و ساختار ابزارسازی یک شرکت خاص، ریسک عدم انعطاف و وابستگی اقتصادی خطرناکی به همراه دارد.
- پیچیدگی یکپارچه سازی API های ناهمگون: نبود پروتکل های یکسان میان ارائه دهندگان تجاری و سرورهای محلی، مهندسان را درگیر تبدیل فرمت های ورودی، مدیریت خطاها و نگهداری کدهای بی نظم می کند.
- انفجار هزینه های استنتاج (Inference Costs): ارسال درخواست های تکراری، استفاده نابجا از مدل های عظیم چندصد میلیارد پارامتری برای تسک های ساده و ناتوانی در مدیریت توکن ها، به سادگی بودجه های مالی کسب و کار را می سوزاند.
- رفتار غیر قطعی و نوسانات شدید تاخیر (Latency Jitter): عدم تضمین زمان پاسخدهی توسط تامین کنندگان ابری و فقدان مکانیزم های بازگشت خودکار (Fallback) می تواند تجربه کاربری محصول نهایی را به کلی تخریب کند.
این چالش ها اثبات می کنند که ساخت برنامه های کاربردی هوش مصنوعی تنها به مهندسی پرامپت خلاصه نمی شود؛ بلکه نیازمند معماری سیستم های توزیع شده و مدیریت دقیق زیرساخت نرم افزاری است.
۳. ارکان و قابلیت های اساسی در معماری AI Harness
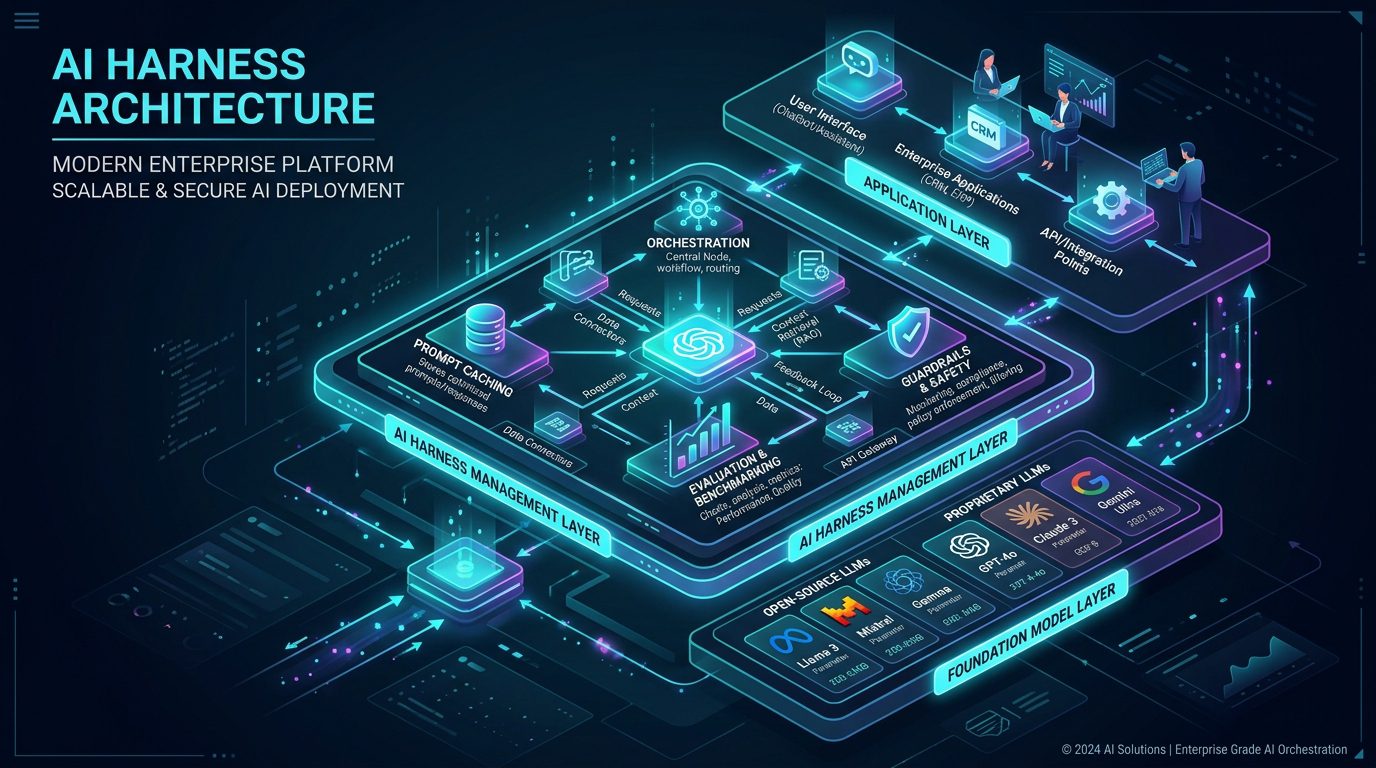
یک چارچوب AI Harness حرفه ای به عنوان پلی هوشمند میان منطق بیزنس و شبکه های عصبی عمل می کند. این چارچوب چهار ستون عملیاتی اصلی را پوشش می دهد:
الف) ارکستراسیون و هدایت هوشمند بار (Intelligent Orchestration & Routing)
وظیفه ارکستراسیون تنها بازفرستادن ساده درخواست ها نیست. یک Harness کارآمد ابتدا متن پرامپت را از نظر سطح پیچیدگی، نیاز به فراخوانی توابع بیرونی (Tool Use) و حساسیت داده تحلیل می کند. سپس درخواست را به بهینه ترین مدل هدایت می نماید. علاوه بر این، با پیاده سازی الگوهای طراحی مدار شکن (Circuit Breaker)، در صورتی که یک سرویس دهنده دچار خطای محدودیت نرخ (Rate Limit 429) یا تاخیر غیرعادی شود، ترافیک بلافاصله به مدل های جایگزین هدایت می گردد.
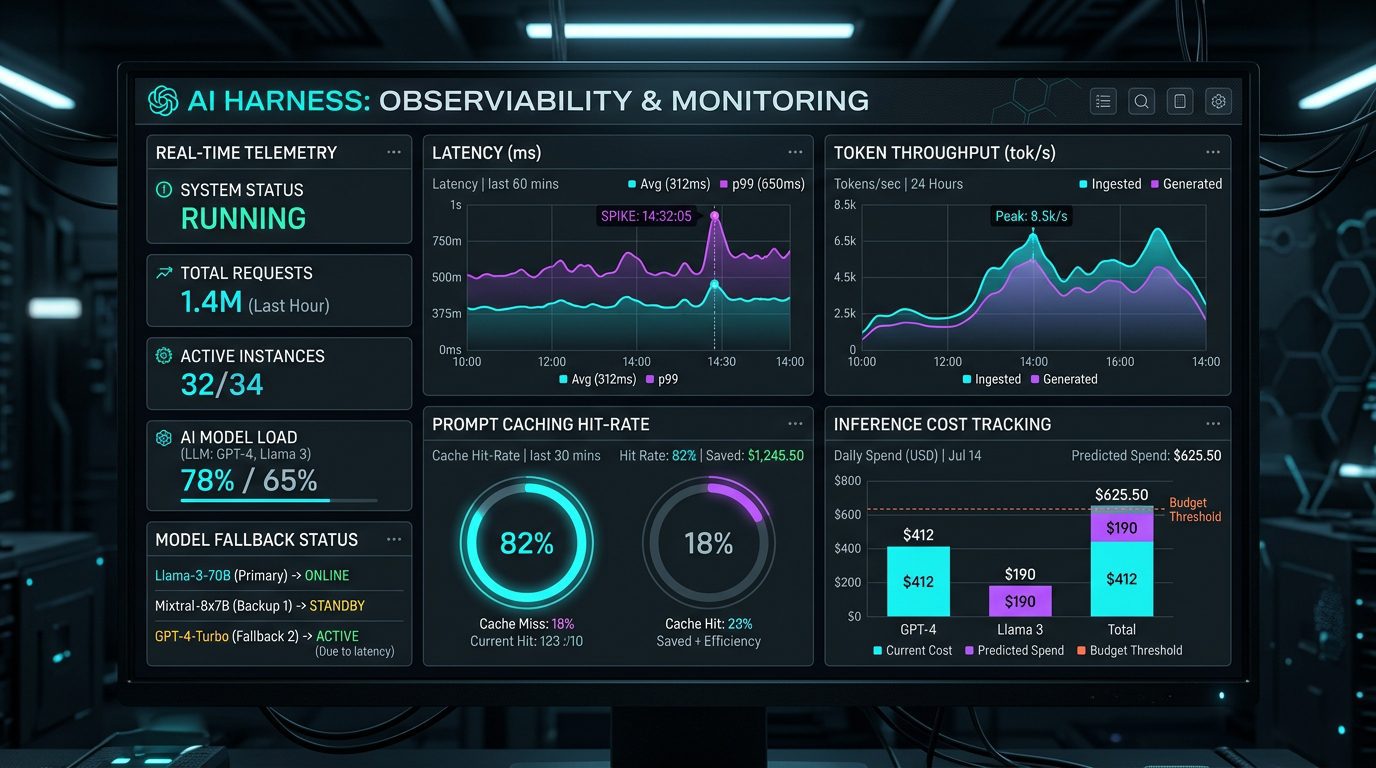
ب) مشاهده پذیری و پایش بلادرنگ (Observability & Telemetry)
بدون مشاهده پذیری دقیق، بهینه سازی سیستم ناممکن است. AI Harness تمام ورودی ها و خروجی ها را بر بستر استانداردهای بین المللی باز نظیر OpenTelemetry ردیابی می کند. مهندسان از طریق تله متری می توانند پارامترهای زیر را به شکل تفکیک شده تحلیل کنند:
- تاخیر اولین توکن (Time To First Token – TTFT): معیاری حیاتی برای درک احساس سرعت توسط کاربر در خروجی های استریمینگ.
- توان عملیاتی توکن بر ثانیه (Token Throughput): سنجش پایداری پردازش در ساعات اوج بار سرور.
- هزینه دقیق هر تراکنش و ردیابی بودجه: محاسبه بلادرنگ مبالغ ارزی مصرف شده به ازای هر کاربر، نشست یا دپارتمان سازمانی.
ج) کش پرامپت و کش معنایی (Prompt Caching & Semantic Caching)
یکی از بزرگ ترین اهرم های کاهش هزینه، بهره گیری از کش هوشمند است. کش های سنتی کلید-مقدار (Key-Value) تنها در صورتی فعال می شوند که متن ورودی کاراکتر به کاراکتر تطابق داشته باشد. اما درون معماری AI Harness، ماژول کش معنایی با بهره گیری از دیتابیس های برداری و محاسبه فاصله کسینوسی امبدینگ ها، پرسش های با مفهوم یکسان را شناسایی کرده و پاسخ از پیش ذخیره شده را با تاخیری کمتر از ۳۰ میلی ثانیه بازمی گرداند.
د) ارزیابی مداوم و گاردریل های امنیتی (Evaluation & Guardrails)
چارچوب Harness پیش از ارسال پاسخ به کاربر نهایی، فیلترهای اعتبارسنجی را اعمال می کند. این لایه مانع از حملات تزریق پرامپت (Prompt Injection)، خروج داده های محرمانه شخصی (PII) و تولید پاسخ های موهوم (Hallucination) می شود. همچنین با متدهای خودکار ارزیابی مدل با مدل (LLM-as-a-Judge)، کیفیت پاسخ ها به طور پیوسته امتیازدهی می گردد.
۴. معماری پیشنهادی: ایجاد تعادل میان مدل های متن باز و بسته
یکی از درخشان ترین دستاوردهای پیاده سازی معماری AI Harness، توانایی ایجاد سیستم های ترکیبی (Hybrid Multi-Tier Architecture) است. در این الگو، به جای تکیه انحصاری بر سرویس های گران قیمت ابری، وظایف بر اساس ماهیت و بار محاسباتی توزیع می شوند.
همان گونه که در تحلیل جامع انقلاب SLM ها و مدل های زبانی کوچک اشاره کردیم، بیش از ۶۰ درصد پرسش های متداول اداری، خلاصه سازی های کوتاه و دسته بندی داده ها می توانند توسط مدل های بهینه درون سازمانی پاسخ داده شوند.
الگوی عملیاتی تخصیص بار کاری (Tiered Execution Strategy):
- لایه اول (سبک، سریع و محلی): استقرار مدل های سبک متن باز نظیر Llama 3 8B یا Mistral بر بستر موتورهای استنتاج پرسرعت مانند vLLM یا Ollama بر روی سرورهای داخلی شرکت. این لایه وظیفه پاسخگویی به درخواست های عمومی و دسته بندی اولیه را با هزینه پردازشی ناچیز بر عهده دارد.
- لایه دوم (تخصصی و حریم خصوصی بالا): مدل های تنظیم دقیق شده (Fine-Tuned) برای پردازش پرونده های محرمانه سازمانی، امور مالی و داده های هویتی، به گونه ای که هیچ داده ای از شبکه خصوصی خارج نشود.
- لایه سوم (استدلال پیشرفته و چندمرحله ای): ارسال درخواست های بی نهایت پیچیده تحلیلی و استراتژیک به API های بسته جهانی نظیر Claude 3.5 Sonnet یا GPT-4o تنها در شرایطی که لایه های قبلی ارزیابی کنند نیاز به توان پردازشی مازاد وجود دارد.
نمونه پیاده سازی منطق هدایت در پایتون (Router Logic Example):
# نمونه مفهومی از موتور هدایت هوشمند در لایه AI Harness
class AIHarnessRouter:
    def __init__(self, semantic_cache, local_slm_engine, cloud_llm_gateway):
        self.cache = semantic_cache
        self.local_slm = local_slm_engine
        self.cloud_llm = cloud_llm_gateway

    async def execute_prompt(self, user_prompt: str, user_context: dict) -> dict:
        # گام اول: بررسی حافظه کش معنایی
        cached_response = await self.cache.lookup(user_prompt, threshold=0.92)
        if cached_response:
            return {"source": "semantic_cache", "data": cached_response, "latency_ms": 25}

        # گام دوم: تخمین میزان پیچیدگی درخواست
        complexity_score = self.estimate_complexity(user_prompt)

        # گام سوم: هدایت هوشمند بار محاسباتی
        if complexity_score < 0.65 and not user_context.get("requires_deep_reasoning"):
            try:
                response = await self.local_slm.generate(user_prompt)
                return {"source": "local_slm", "data": response, "cost": 0.0}
            except Exception as error:
                # فعال سازی مدار شکن و بازگشت به لایه پشتیبان ابری
                return await self.cloud_llm.generate(user_prompt, fallback=True)

        return await self.cloud_llm.generate(user_prompt)
۵. مزایای مهندسی پیاده سازی AI Harness
استقرار این چارچوب معماری در زیرساخت نرم افزاری سازمان، مزایای ملموس و شگفت انگیزی به همراه دارد:
- کاهش تاخیر پاسخگویی (Latency Reduction): با پاسخدهی بیش از ۴۰ درصد درخواست ها از طریق کش معنایی و اجرای مدل های محلی سبک، میانگین تاخیر سیستم تا ۷۰ درصد بهبود می یابد.
- استقلال کامل از مدل (Model Agnosticism): جابجایی بین تامین کنندگان هوش مصنوعی دیگر نیازمند تغییر در کدهای اپلیکیشن نیست. شما می توانید با تغییر یک متغیر در فایل تنظیمات، ارائه دهنده را تغییر دهید.
- امنیت داده ها و انطباق قانونی: بررسی و پاکسازی داده های ورودی و خروجی در راستای استانداردهای بین المللی و سیاست های حفاظت از داده ها در عصر هوش مصنوعی به طور خودکار انجام می گیرد.
- کنترل و کاهش هزینه های استنتاج (Cost Governance): با ممانعت از ارسال پرامپت های تکراری و هدایت درخواست های سبک به مدل های ارزان، هزینه های ماهانه صورتحساب های هوش مصنوعی به شکل چشمگیری مهار می شود.
| شاخص عملکرد | اتصال مستقیم به API ها (بدون Harness) | معماری یکپارچه AI Harness |
|---|---|---|
| وابستگی به زیرساخت (Lock-in) | بسیار شدید؛ هزینه بازنویسی بالا | صفر؛ جابجایی بلادرنگ با کانفیگ |
| بهینه سازی هزینه استنتاج | کنترل نشده و صعودی | کاهش ۵۰ تا ۸۰ درصدی با کش و SLM |
| پایداری و مقاومت در برابر خطا | توقف برنامه در صورت قطعی سرویس دهنده | تاب آوری بالا با مدارهای بازگشت خودکار |
| مشاهده پذیری و تله متری | لاگ های پراکنده و مبهم | داشبورد یکپارچه با متریک های استاندارد |
۶. نتیجه گیری: شالوده برنامه های کاربردی آینده
جهان توسعه نرم افزار در حال سپری کردن گذاری تاریخی از رویکردهای مدل محور (Model-Centric) به سمت معماری های چارچوب محور و چندعاملی (Harness-Centric Architecture) است. در آینده ای بسیار نزدیک، ارزش بنیادین محصولات دیجیتال نه در انتخاب یک چکیده زبانی خاص، بلکه در توانمندی لایه های مدیریتی برای هدایت، اعتبارسنجی و مهار این مدل ها تعریف خواهد شد.
پیاده سازی معماری AI Harness به تیم های فنی این آرامش خاطر را می بخشد که سیستم های آنها در برابر طوفان تغییرات فناورانه همواره پایدار، بهینه و چابک باقی می مانند. این چارچوب همان زیرساخت اساسی است که رویاهای مهندسی امروز را به راهکارهای تجاری مطمئن فردا پیوند می زند.
اگر در حال پیاده سازی سامانه های پیشرفته مبتنی بر هوش مصنوعی هستید و می خواهید زیرساخت و نرم افزارهای خود را با جدیدترین الگوهای مقیاس پذیر معماری کنید، جهت دریافت راهکارهای فنی و مشاوره تخصصی و طراحی سیستم های هوش مصنوعی در طراحان نوین با کارشناسان ارشد ما در ارتباط باشید.